TP 4 : Classification supervisée, éléments de cours
Cette page ne contient pas un cours complet sur le sujet. Il contient seulement quelques points que je souhaite illustrer expérimentalement.
On utilise les arbres de décision. La partie pratique est décrite en Python et en R. Les codes indiquées en Python et en R font la même chose. Chaque étudiant choisit le langage dans lequel il souhaite travailler. Je conseille d'utiliser R.
Induction d'un arbre de décision
Deux phases :
- Construction d'un arbre de décision.
- Élagage de cet arbre qui, en simplifiant l'arbre, augmente la probabilité qu'il prédise correctement la classe d'une donnée.
On ne détaille pas ces points ici.
Évaluation d'un arbre de décision
Supposons que l'on ait construit un arbre de décision. Par exemple, en exécutant ce code :
import numpy as np
import pandas as pd
olives = pd.read_csv ("olives.csv", header = 0)
olives.rename (columns = {"Unnamed: 0": "Area Name"}, inplace = True)
olives ["Area Name"] = olives ["Area Name"].astype("category")
olives ["region"] = olives ["region"].astype("category")
olives ["area"] = olives ["area"].astype("category")

from sklearn import tree
from sklearn.model_selection import train_test_split

olives_Xtrain, olives_Xtest, olives_Ytrain, olives_Ytest = \
    train_test_split (olives.iloc [:,3:11], olives.iloc [:,0], test_size = .2)
arbre = tree.DecisionTreeClassifier (min_samples_leaf = 2)
arbre = arbre.fit (olives_Xtrain, olives_Ytrain)
olives <- read.csv ("olives.csv")
names (olives) [1] <- "Area.Name"
olives$region <- factor (olives$region)
olives$Area.Name <- factor (olives$Area.Name)
olives$area <- factor (olives$area)

N <- nrow (olives)
test.size <- 0.2
Ntest <- floor (N * test.size)
Ntrain <- N - Ntest
olivesTrain.indices <- sample.int (N, Ntrain)
olivesTest.indices <- setdiff (1:N, olivesTrain.indices)

require (rpart)

arbre <- rpart (Area.Name ~ . - area - region, olives, subset = olivesTrain.indices)
Le détail n'importe pas : j'ai pris un jeu de données et j'essaie de prédire un attribut catégorique. Les codes en Python et en R ne sont pas exactement identiques mais ils réalisent le même traitement ; on peut facilement transformer l'un ou l'autre pour que les deux soient identiques (sachant que la méthode pour construire l'arbre de décision en Python et celle utilisée en R ne sont pas exactement les mêmes, celle de R étant de meilleure qualité que celle de Python).
La question qui nous occupe et d'estimer le taux de succès de cet arbre de décision, c'est-à-dire la probabilité que l'arbre détermine correctement la classe d'une donnée.
On sait que pour cela, il faut utiliser des exemples qui n'ont pas été utilisés pour construire l'arbre. On a donc pris soin de découper le jeu d'exemples (le tableau de données olives) en deux parties :
- le jeu d'entrainement utilisé pour la construction de l'arbre : en Python, olives_Xtrain et olives_Ytrain contiennent ces exemples ; en R, olivesTrain.indices contient les indices des exemples du jeu d'entraînement.
- le jeu de test utilisé pour estimer le taux de succès : en Python, olives_Xtest et olives_Ytest ; en R, olivesTest.indices contient les indices des exemples du jeu de test.
On peut donc prédire la classe des données du jeu de test et comparer la classe prédite avec celle attendue.
taux_succès = sum (arbre.predict (olives_Xtest) == olives_Ytest) / olives_Xtest. shape [0]
print ("Taux de succès estimé : {:.2f}". format (taux_succès))
J'insiste sur le print () et l'utilisation de la méthode format (). Si on n'y prend pas garde, Python affiche plus de 10 décimales, ce qui est ridicule. 2 ou 3 chiffres significatifs sont suffisants : la précision des résultats n'est pas du tout à 10-10 près, cela n'a donc aucun sens d'afficher 10 décimales.
Il y a plusieurs manières de faire ce calcul. Il y a notamment au moins deux fonctions qui le calcule directement : la méthode score () :
print ("Taux de succès estimé : {:.2f}". format (arbre.score (olives_Xtest, olives_Ytest)))
et la méthode accuracy_score () :
from sklearn.metrics import accuracy_score
print ("Taux de succès estimé : {:.2f}". format (accuracy_score (olives_Ytest, arbre.predict (olives_Xtest))))
Ces trois manières de faire donnent le même résultat.
prédiction <- predict (arbre, olives [olivesTest.indices, ])
étiquettes.prédites <- apply (prédiction, 1, function (ligne) return (levels(olives$Area.Name)[which (ligne != 0)]))

taux.succès <- sum (étiquettes.prédites == olives$Area.Name [olivesTest.indices]) / Ntest
print (as.numeric (format (taux.succès, digits = 3)))
La dernière ligne qui peut paraître compliquée permet de n'afficher que 3 décimales, ce qui est amplement suffisant.
Et si l'utilisation de la fonction apply() vous semble obscure, vous pouvez utilisez la fonction pp.score() que je vous fournis dans ce fichier (on peut sourcer ce fichier dans R avec la commande source ("https://philippe-preux.codeberg.page/ensg/miashs/R/pp.score.R")). Dans ce cas, on écrira simplement
taux.succès <- pp.score (arbre, olives [olivesTest.indices,], olives$Area.Name [olivesTest.indices])
cat ("Taux de succès estimé : ", format (pp.score (arbre, olives [olivesTest.indices, ], olives$Area.Name [olivesTest.indices]), digits = 3), "\n")
à la place de ce qui précède.
Si j'exécute ce code, j'obtiens :
Taux de succès estimé : 0.90
ce qui semble un assez bon résultat, 90% des exemples de test étant bien prédits (103 bien prédits sur 115 exemples de test).
Ré-exécutons ce code, j'obtiens :
Taux de succès estimé : 0.91
Ça augmente ! Encore une fois :
Taux de succès estimé : 0.92
De mieux en mieux ! Y aurait-il une loi qui fait que plus j'exécute ce bout de code, meilleures sont les performances ? Serait-ce un exemple des pouvoirs surnaturels de l'IA ? Retentons l'expérience :
Taux de succès estimé : 0.90
aïe ! Probablement, un manque de chance, recommençons :
Taux de succès estimé : 0.86
ouh là, arrêtons d'exécuter ce code, il empire maintenant.
Si j'exécute ce code, j'obtiens :
Taux de succès estimé : 0.82
c'est-à-dire que 82% des exemples de test sont correctement prédits (93 sur 114).
Recommençons :
Taux de succès estimé : 0.91
c'est beaucoup mieux !
Recommençons :
Taux de succès estimé : 0.89
aïe ! Probablement, un manque de chance, recommençons :
Encore une fois :
Taux de succès estimé : 0.84
ouh là, arrêtons d'exécuter ce code, il empire maintenant.
On peut continuer d'exécuter ce code. Parfois le taux de succès va augmenter, parfois diminuer.
Finalement, c'est quoi LA bonne valeur du taux de succès ?
Pour avancer, comme il n'y a absolument rien de magique ou de surnaturel dans un ordinateur, il faut comprendre pourquoi on obtient ces résultats.
Avant cela, exécuter ce code sur votre ordinateur plusieurs fois. Observez-vous la même chose que moi ? Obtenez-vous les mêmes taux de succès ?
Avant de lire la suite, réflêchissez à ce qui peut causer cette variabilité.
Il faut donc se demander ce qui fait que le résultat du code listé plus haut peut changer. Toutes les instructions composant ce code sont parfaitement déterministes, sauf une en R et deux en Python, et c'est de là que provient cette variabilité du résultat.
Lors du partionnement du jeu d'exemples en jeu d'entraînement et jeu de test, on fait appel à une fonction non déterministe qui génère de l'aléa : la fonction train_test_split () en Python, la fonction sample.int () en R. Exécutez deux fois ces fonctions, vous obtenez des résultats à chaque exécution. Aussi, l'arbre de décision est construit avec des jeux d'exemples différents donc l'arbre peut être différent. De plus, quand on estime son taux de succès, le jeu de test est lui aussi différent. De ce fait, un même arbre de décision pourra avoir des taux de succès différents sur deux jeux de test différents. Donc, les taux de succès de deux arbres différents estimés sur deux jeux de test différents ont toutes les chances d'être différents.
Par ailleurs, en Python (pas en R), la construction de l'arbre de décision contient une part d'aléa : pour un même jeu d'entraînement, la fonction DecisionTreeClassifier peut donner des arbres différents si on l'appelle plusieurs fois.
Si ces instructions donnaient toujours le même résultat à chaque exécution, le résultat final du code serait toujours le même. Ce point est excessivement important, il concerne la reproductibilité expérimentale : dans toutes les sciences expérimentales, les résultats d'une expérience doivent pouvoir être reproduits. Un ordinateur étant une machine extrêmement précise dans laquelle le hasard est (presque) totalement absent (il l'est en tout cas pour ce bout de code), un programme doit pouvoir toujours donner le même résultat. Aussi, si on veut que le hasard apparaisse dans le fonctionnement d'un programme, ce hasard doit être contrôlé et on doit pouvoir le faire disparaître pour rendre le code complétement déterministe, donnant donc toujours le même résultat à chaque exécution. Dans un ordinateur, le hasard est engendré par des algorithmes qui génèrent une suite de nombres qui possède les propriétés du hasard (les nombres qui se suivent ne se ressemblent pas , etc.) mais qui sont parfaitement déterministes. Pour cela, on utilise une suite récurrente qui a les propriétés attendues ; cette suite dépend d'un nombre initial connu sous le nom de graine (c'est le terme u0 d'une suite un vue en cours de maths). L'étude de ces suites qui génèrent une séquence de nombres qui semble aléatoire est un sujet extrêmement important depuis les débuts de l'informatique, dans les années 1940. Les nombres ainsi générés sont dits « pseudo-aléatoires » ; le préfixe pseudo indique qu'ils ne sont en rien aléatoires. Ils sont générés de manière parfaitement déterministe. Néanmoins, quand on observe la suite de nombres ainsi générés, celle-ci semble véritablement constituée d'une succession de nombres pris au hasard.
Pour tout dire, on ne sait pas si le hasard existe vraiment dans l'univers.
En résumé, dans un programme, quand on veut faire intervenir le hasard, on utilise un générateur de nombres pseudo-aléatoires dont on fixe la graine. Je reprends le bout de code en y ajoutant cet élément :
import numpy as np

graine = 2092025
rs = np.random.RandomState (graine)

import pandas as pd
olives = pd.read_csv ("olives.csv", header = 0)
olives.rename (columns = {"Unnamed: 0": "Area Name"}, inplace = True)
olives ["Area Name"] = olives ["Area Name"].astype("category")
olives ["region"] = olives ["region"].astype("category")
olives ["area"] = olives ["area"].astype("category")

from sklearn import tree
from sklearn.model_selection import train_test_split, cross_validate, KFold

olives_Xtrain, olives_Xtest, olives_Ytrain, olives_Ytest = \
    train_test_split (olives.iloc [:,3:11], olives.iloc [:,0], test_size = .2, random_state = rs)
arbre = tree.DecisionTreeClassifier (min_samples_leaf = 2, random_state = rs)
arbre = arbre.fit (olives_Xtrain, olives_Ytrain)
taux_succès = sum (arbre.predict (olives_Xtest) == olives_Ytest) / olives_Xtest. shape [0]
print ("Taux de succès estimé : {:.2f}". format (taux_succès))
set.seed (2781653)
olives <- read.csv ("olives.csv")
names (olives) [1] <- "Area.Name"
olives$region <- factor (olives$region)
olives$Area.Name <- factor (olives$Area.Name)
olives$area <- factor (olives$area)

N <- nrow (olives)
test.size <- 0.2
Ntest <- floor (N * test.size)
Ntrain <- N - Ntrain
olivesTrain.indices <- sample.int (N, Ntrain)
olivesTest.indices <- setdiff (1:N, olivesTrain.indices)

require (rpart)

arbre <- rpart (Area.Name ~ . - area - region, olives, subset = olivesTrain.indices)
taux.succès <- pp.score (arbre, olives [olivesTest.indices,], olives$Area.Name [olivesTest.indices])
cat ("Taux de succès estimé : ",
    format (pp.score (arbre, olives [olivesTest.indices, ], olives$Area.Name [olivesTest.indices]), digits = 3), "\n")
Exécutons ce code plusieurs fois. À chaque fois, il donne le même résultat, 0,94 en Python, 0,89 en R (c'est par hasard que le taux de succès en Python est plus élevé qu'en R). Et encore plus fort, cette fois-ci, vous obtenez le même résultat que moi et que vos voisins. Ce code est parfaitement reproductible. Le jour du contrôle, si vous me donnez un code reproductible, je vais obtenir les mêmes résultats que vous et pouvoir vérifier vos réponses aux questions, éventuellement vous expliquez ce que vous n'avez pas bien fait.
La graine est utilisée pour initialiser le générateur de nombres pseudo-aléatoires stocké dans la variable rs. Ensuite, ce générateur de nombres pseudo-aléatoires est passé en paramètre des deux fonctions identifiées plus haut comme ayant un comportement aléatoire.
En R, c'est très simple (parce que c'est mieux conçu qu'en Python), il suffit d'appeler la fonction set.seed () en lui passant en paramètre la graine (un nombre entier). Il faut effectuer cet appel avant tout appel au générateur de nombres pseudo-aléatoires. C'est une bonne idée que ce soit la première instruction que vous effectuez.
À ce stade, on a obtenu un programme dont le résultat est reproductible.
Estimation du taux de succès : influence de la graine
Que se passe-t-il si on change de graine ? Mettez 261735411, exécutez et observez.
À chaque exécution, on obtient toujours Taux de succès estimé : 0.90 en Python, 0,89 en R.
Mais avant on obtenait 0,94 en Python (en R, on obtenait la même valeur par le plus grand des hasards !). Quelle est la bonne valeur ?
Changez la graine et constatez : pour chaque graine, on obtient un résultat différent. Même en ne changeant que d'une unité, on obtient en général des valeurs différentes (et si on obtient la même, c'est par hasard !).
Conclusion : pour chaque graine, on obtient un taux de succès différent.
Estimation du taux de succès : influence du nombre d'estimations
Plutôt que de changer de graine, estimons le taux de succès d'une succession d'arbres de décision construit avec la même graine. Une fois la graine fixée, on itère le processus suivant :
- construire l'arbre de décision,
- estimer son taux de succès,
- l'ajouter à une liste.
À l'issue de 100 itérations, on a construit 100 arbres de décision dont on a estimé le taux de succès. On peut en faire un histogramme. Avec la graine utilisée plus haut (2092025), J'obtiens :

On voit que sur 100 estimations, le taux de succès varie entre 0,8 et 1. La moyenne est 0,8939, la médiane 0,8913. Cette différence se confirme à l'œil où la distribution semble ne pas être symétrique, donc n'est pas normale. (Sur cet exemple, cela ne saute pas forcément aux yeux, sur d'autre c'est le cas, de même que la différence entre moyenne et médiane n'est pas très grande.)
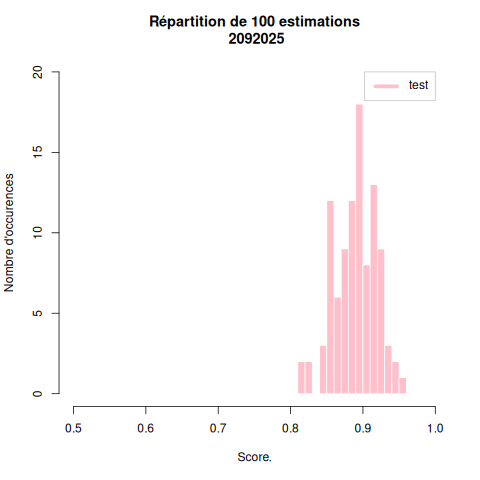
On voit que sur 100 estimations, le taux de succès varie entre 0,8 et 1. La moyenne est 0,8899, la médiane 0,8947. Cette différence se confirme à l'œil où la distribution semble ne pas être symétrique, donc n'est pas normale. (Sur cet exemple, cela ne saute pas forcément aux yeux, sur d'autre c'est le cas, de même que la différence entre moyenne et médiane n'est pas très grande.)
On peut faire le même graphique avec une autre graine. On n'obtient pas la même chose, mais les histogrammes se ressemblent beaucoup. En voici 3 autres :


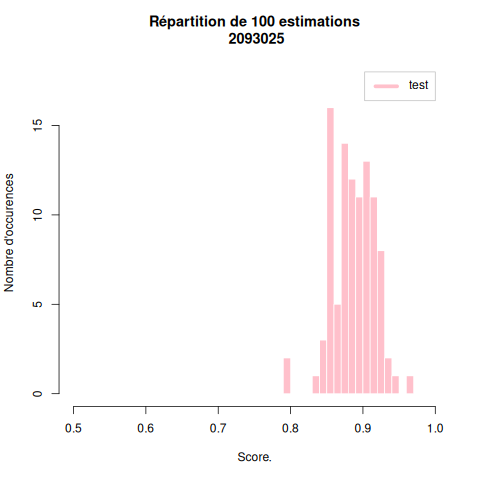
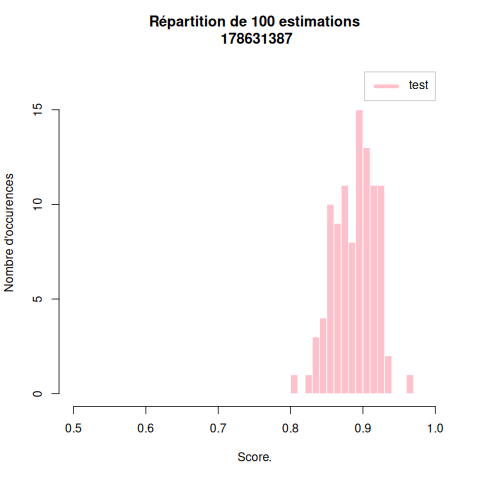
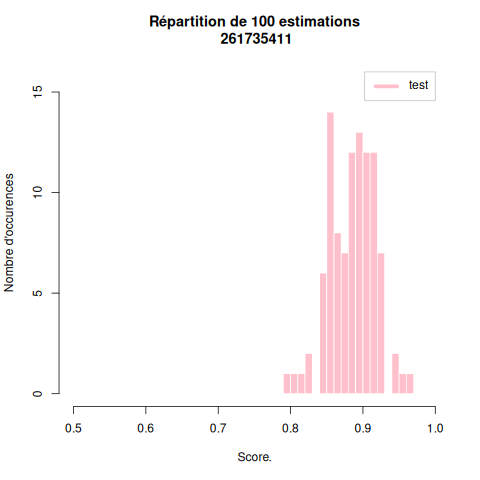
Que faut-il conclure ?
Il est difficile de tirer une conclusion simple et tranchée. C'est la réalité de la science des données.
Estimation du taux de succès par validation croisée
La manière conseillée d'estimer ce taux de succès est d'utiliser la méthode de validation croisée.
Après avoir créé l'objet arbre (même code que précédemment, simple rappel)) :
import numpy as np

graine = 2092025
rs = np.random.RandomState (graine)

import pandas as pd
olives = pd.read_csv ("olives.csv", header = 0)
olives.rename (columns = {"Unnamed: 0": "Area Name"}, inplace = True)
olives ["Area Name"] = olives ["Area Name"].astype("category")
olives ["region"] = olives ["region"].astype("category")
olives ["area"] = olives ["area"].astype("category")

from sklearn import tree
from sklearn.model_selection import train_test_split

olives_Xtrain, olives_Xtest, olives_Ytrain, olives_Ytest = \
    train_test_split (olives.iloc [:,3:11], olives.iloc [:,0], test_size = .2, random_state = rs)
arbre = tree.DecisionTreeClassifier (min_samples_leaf = 2, random_state = rs)
On reprend le code précédent qui induit un arbre (même code que précédemment, simple rappel)) :
set.seed (2092025)
olives <- read.csv ("/home/ppreux/philippe-preux.codeberg.org/pages/ensg/miashs/datasets/olives.csv")
names (olives) [1] <- "Area.Name"
olives$region <- factor (olives$region)
olives$Area.Name <- factor (olives$Area.Name)
olives$area <- factor (olives$area)
N <- nrow (olives)

test.size <- 0.2
Ntest <- floor (N * test.size)
Ntrain <- N - Ntest
olivesTrain.indices <- sample.int (N, Ntrain)
olivesTest.indices <- setdiff (1:N, olivesTrain.indices)
from sklearn.model_selection import cross_val_score
s = np.mean (cross_val_score (arbre, olives.iloc [:, 3:olives.shape[1]], olives.iloc [:,0], cv = 10))
On a fixé le nombre de parties (plis/folds) à 10 via le paramètre cv.
En R, il n'y a pas de fonction qui effectue une validation croisée. On verra plus tard que quand on induit un arbre de décision, celle-ci est calculée par la fonction rpart(). Pour l'instant, on va estimer le taux de succès par validation croisée « à la main », simplement en programmant une boucle.
cv.nfolds <- 10 # nombre de plis de la validation croisée
K <- floor (N / cv.nfolds)
cv.permutation <- sample.int (N, N)
cv.taux.succès <- rep (NA, times = cv.nfolds)
cv.test.indices <- cv.permutation [((k-1) * K + 1):(k * K)]
cv.train.indices <- setdiff (1:(cv.nfolds*K), cv.test.indices)
cv.arbre <- rpart (Area.Name ~ . - area - region, olives, subset = cv.train.indices)
cv.prédiction <- predict (cv.arbre, olives [cv.test.indices,])
cv.taux.succès [k] <- pp.score (arbre, olives [cv.test.indices,], olives$Area.Name [cv.test.indices])
s <- mean (cv.taux.succès)
À l'issue de l'exécution de ce code, s contient le taux de succès estimé par la moyenne des 10 taux estimés avec chacun des 10 plis.
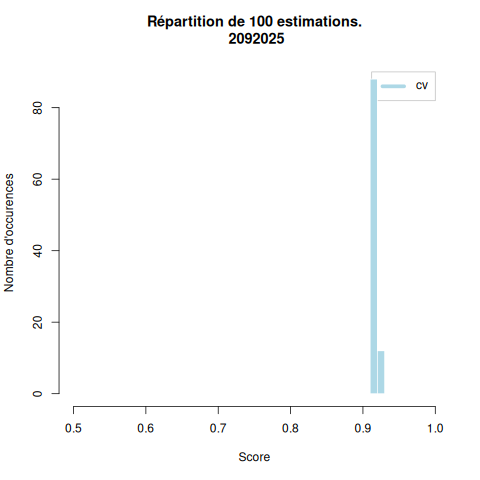
On peut réaliser une validation croisée et prendre le résultat moyen (comme ce que l'on vient de faire). On peut aussi, comme plus haut, réaliser un certain nombre de validation croisée (ici 100) et à nouveau en faire un histogramme des 100 taux de succès moyens ainsi obtenus. J'obtiens cela :

que l'on peut superposer avec l'histogramme du taux de succès précédent :

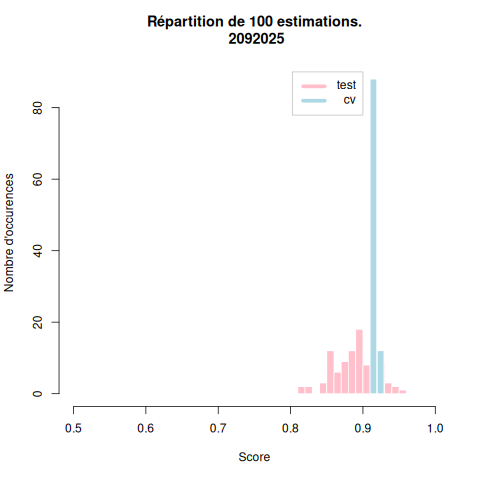
On voit que les scores obtenus par validation croisée sont plus concentrés que ceux obtenus précédemment en estimant le taux de succès. On a tendance à utiliser cette estimation pour caractériser le taux de succès d'un arbre de décision construit (de cette manière-là) sur le jeu de données, en particulier sa moyenne qui vaut ici 0,908, la médiane valant aussi 0,909 en Python, (moyenne ~ 0.9195 et médiane ~ 0.9193 en R : j'indique ici 4 décimales pour que l'on distingue la moyenne de la médiane).
Pour illustrer le fait qu'il ne faut surtout pas utiliser les exemples ayant servi pour l'entraînement pour estimer le taux de succès, je superpose l'histogramme des taux de succès mesurés sur le jeu d'entraînement :

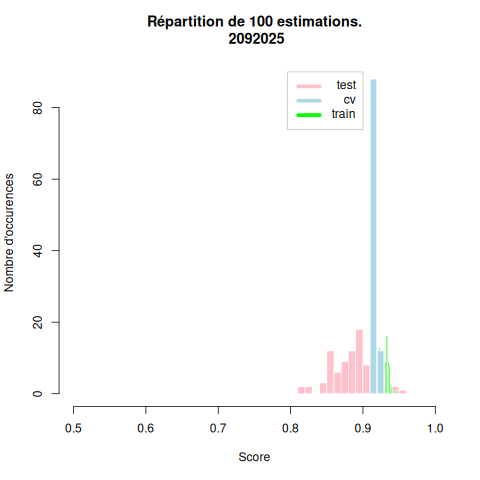
On voit que l'estimation mesurée sur le jeu d'entraînement est trop optimiste (médiane 0,98 en Python, 0,93 en R).